대규모 데이터를 GPU에 얼마나 빠르고 안정적으로 공급하느냐가 AI 워크로드의 처리 속도와 GPU 활용률을 결정합니다.
GPU 대기 시간
스토리지의 데이터 공급 속도가 GPU 연산 속도를 따라가지 못하면 고가의 GPU 자원이 유휴 상태에 놓입니다.
데이터 증가와 성능 저하
학습 데이터와 체크포인트가 증가하면 저장 용량뿐 아니라 처리량과 메타데이터 성능도 함께 확장되어야 합니다.
복잡한 데이터 운영
데이터 수집·학습·보호·아카이빙 환경이 분리되면 데이터 이동과 관리 복잡성이 증가합니다.
ExaStor: AI/HPC 워크로드를 가속하는 고성능 AI 스토리지
ExaStor는 Lustre 병렬 파일 시스템과 스케일아웃 아키텍처를 기반으로, 대규모 GPU 클러스터에 데이터를 빠르고 안정적으로 공급하는 글루시스의 AI 스토리지입니다.
AI 데이터와 메타데이터를 여러 스토리지 타깃에 분산하고 다수의 GPU 서버에서 발생하는 입출력을 병렬로 처리해, 스토리지 병목과 GPU 대기 시간을 줄입니다.
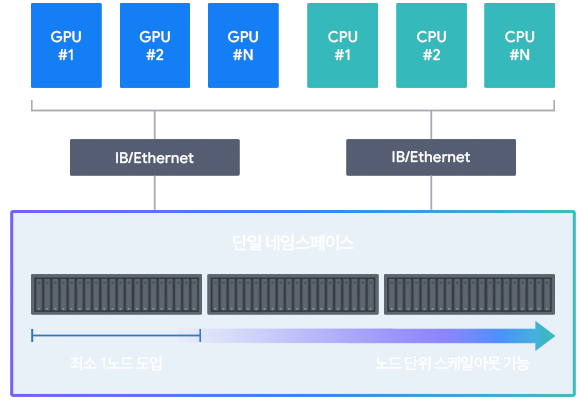
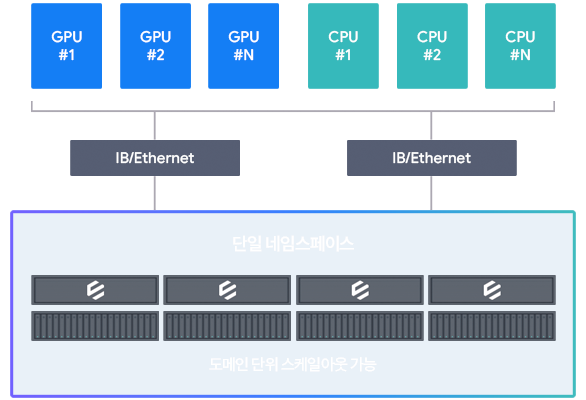
원본 데이터, 학습 데이터셋, 체크포인트 및 아카이브 데이터를 하나의 글로벌 네임스페이스에서 관리하며, 단일 노드부터 시작해 용량과 성능을 함께 확장할 수 있습니다.
GPU 활용 극대화
고대역폭 데이터 공급으로 GPU 대기 시간을 줄이고 AI 학습과 추론의 처리 효율을 높입니다.
병렬 데이터 처리
Lustre 기반 병렬 파일 시스템으로 다수의 GPU 서버에서 발생하는 대규모 입출력을 동시에 처리합니다.
메타데이터 가속
분산 메타데이터와 소형 파일 최적화 기술로 대규모 파일 환경의 병목을 완화합니다.
유연한 구성 및 확장
단일 노드부터 시작해 데이터 증가에 따라 용량과 처리량을 함께 확장할 수 있습니다.
데이터 배치 최적화
데이터 특성과 접근 패턴에 맞는 저장 계층을 활용해 성능과 비용을 최적화합니다.
엔터프라이즈 데이터 보호
고가용성, 스냅샷, 원격 복제 및 데이터 무결성 검증으로 AI 데이터와 서비스의 연속성을 보호합니다.
0GiB/s
Seq. Read
0kIOPS
Find
0%
CPU 사용 절감률 (GDS)
0X
데이터 용량 절감
성능을 넘어, 엔터프라이즈 AI 데이터 플랫폼으로
고성능 데이터 처리
고가용성 및 데이터 보호
확장성과 데이터 최적화
유연한 연동 및 통합 운영 관리
고성능 병렬 파일 시스템
AI/ML 및 HPC 환경에서는 여러 클라이언트가 동일한 데이터에 동시에 접근합니다.
ExaStor는 Lustre 파일시스템을 기반으로 데이터를 여러 스토리지 노드에 오브젝트 단위로 분산 저장하고, 하나의 글로벌 네임스페이스로 통합 제공합니다.
다수 클라이언트의 입출력을 여러 노드에서 병렬로 처리해 데이터 병목을 완화하고, 학습 과정에서 GPU의 데이터 대기 시간을 줄입니다.
NVIDIA® GPUDirect® Storage
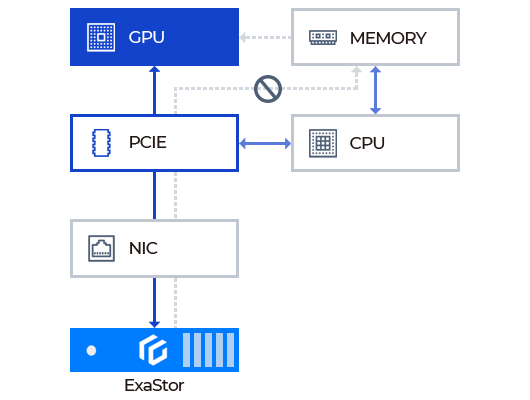
NVIDIA® GPUDirect® Storage는 GPU 메모리와 스토리지 간 직접 데이터 경로를 제공하는 기술입니다.
ExaStor는 CPU와 시스템 메모리를 거치는 불필요한 데이터 복사를 최소화하고, GPU 애플리케이션이 분산 파일시스템의 데이터에 빠르게 접근할 수 있도록 지원합니다.
고속 체크포인트 쓰기
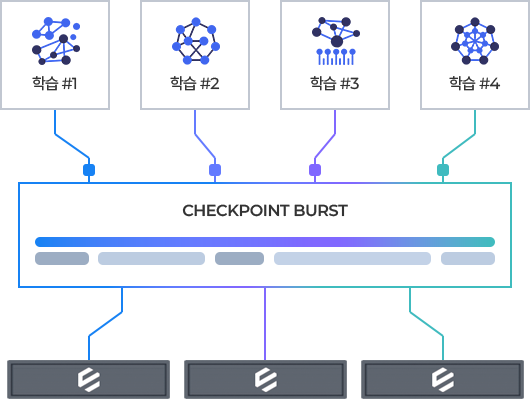
ExaStor는 학습 과정에서 발생하는 대규모 체크포인트 데이터를 여러 스토리지 노드에 분산해 병렬로 처리하고, 메타데이터 캐싱을 통해 저장 시간을 단축합니다. 더욱 빈번한 체크포인트 생성을 지원해 장애 발생 시 재학습해야 하는 구간을 줄이고 학습 연속성을 높입니다.
플래시 기반 확장 캐시
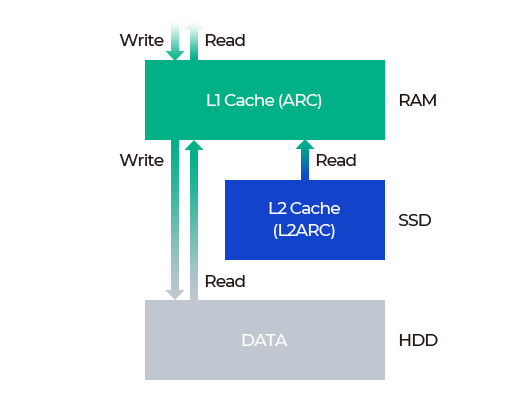
메모리 캐시(ARC)를 SSD 기반 보조 캐시(L2ARC)로 확장해 반복적으로 접근하는 데이터를 플래시 계층에 유지합니다. 메모리 용량의 한계를 보완하고 학습·추론 과정의 읽기 응답 성능을 높이며, 재부팅 후에도 캐시 데이터를 유지해 빠르게 성능을 회복합니다.
하드웨어 이중화
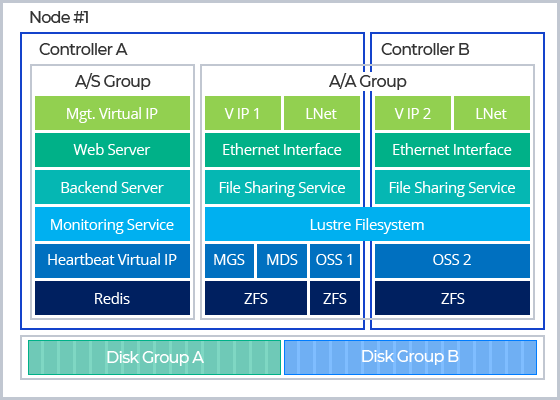
Lustre 파일 시스템을 지원해 병렬 I/O 아키텍처를 통한 듀얼 컨트롤러 기반의 하드웨어 이중화로 특정 컨트롤러에 장애 발생 시 다른 컨트롤러로의 자동 페일오버를 통해 단일 노드만으로 다운타임 없는 서비스 연속성을 보장합니다. 데이터 동기화 방식에서 발생할 수 있는 Split-brain 위험을 원천 차단합니다. (※ DC 모델에 한함)
이중화 아키텍처
Active-Active 스토리지 이중화 아키텍처를 통한 무중단 서비스를 지원합니다. 리소스 간 상호 연관성을 최소화하고 Active-Active 복잡도를 낮춰 부분 Failover를 통한 신속한 장애 복구가 가능합니다.
Multi-Rail 네트워크
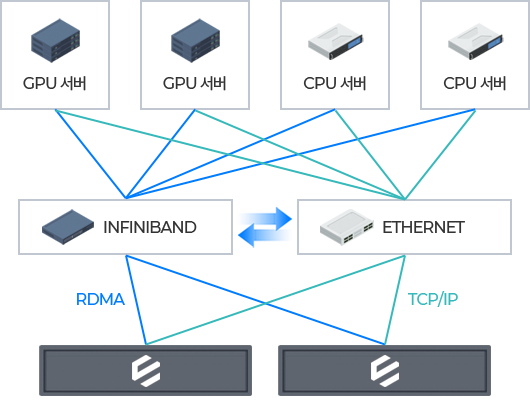
TCP/IP와 RDMA 네트워크 인터페이스를 통합하는 멀티 레일 구성으로 병렬 네트워크 I/O를 지원합니다. 네트워크 트래픽 부하를 로드 밸런싱으로 분산하고 필요에 따라 대역폭을 확장할 수 있어 네트워크 과부하를 방지하고 성능을 최적화 할 수 있습니다.
Flexa Snapshot Manager
Global Write Barrier 기능을 통해 시스템 중단 없이 모든 스토리지 클러스터의 스냅샷을 생성합니다. COW 기반으로 수정되는 부분만 반영해 스냅샷을 빠르게 생성하고, 파일 시스템 하단에서 동작해 메타데이터 성능에 대한 영향을 최소화합니다.
델타 로그 동기화
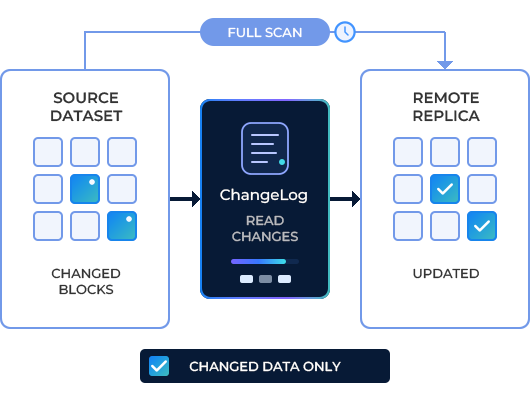
메타데이터 서버의 변경 이력(Change Log)을 기반으로 변경된 데이터만 선별해 동기화합니다. 전체 파일을 다시 검사하지 않아 대규모 학습 데이터셋도 빠르고 효율적으로 원격 복제할 수 있습니다.
정책 기반 TIERING
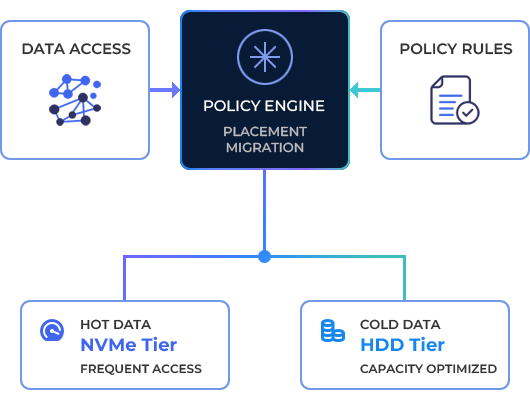
NVMe SSD, SSD, HDD 등 다양한 성능의 스토리지를 하나의 파일 시스템으로 통합하고, 정책 기반 Smart Tiering을 통해 데이터를 자동으로 계층화 합니다.
자주 사용하는 데이터는 고성능 계층에서 빠르게 처리하고, 활용도가 낮은 데이터는 고용량 계층으로 자동 이동하여 스토리지 자원을 효율적으로 활용할 수 있습니다.
스토리지 공간 효율화
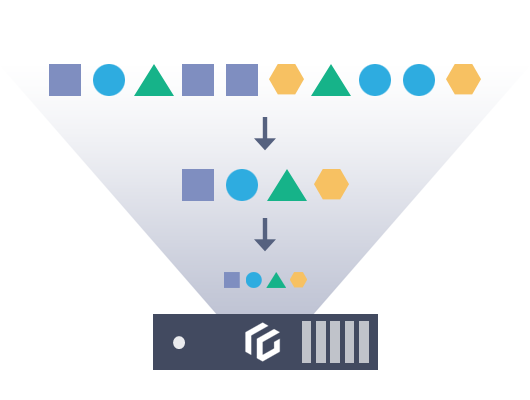
인라인 데이터 압축과 중복제거 기능을 통해 저장 공간을 효율적으로 활용합니다. 데이터를 저장하는 과정에서 중복되는 블록은 하나만 저장하고, 압축 가능한 데이터는 자동으로 압축하여 기록함으로써 동일한 물리적 저장 공간에 더 많은 데이터를 저장할 수 있습니다.
스케일아웃 아키텍처
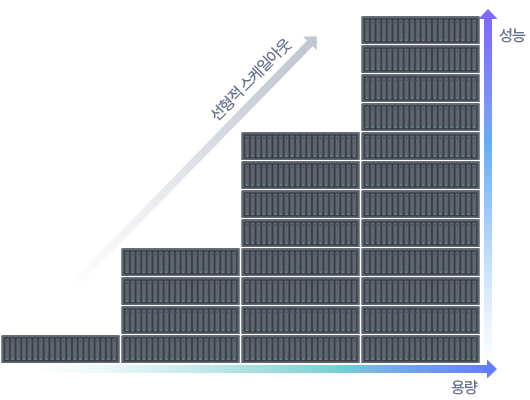
서비스 중단 없이 노드를 추가해 용량과 처리 성능을 함께 확장합니다. 데이터 규모와 GPU 수요 증가에 맞춰 대역폭을 유연하게 높일 수 있으며, 듀얼 또는 싱글 컨트롤러 기반의 단일 노드부터 단계적으로 구축할 수 있습니다.
스케일업 확장
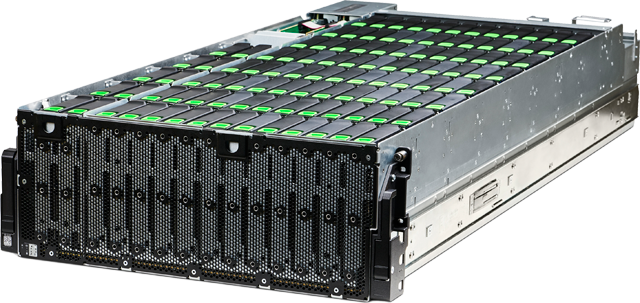
4U 폼팩터에 최대 108개의 SAS 드라이브 탑재가 가능한 고집적 스토리지 인클로저를 지원하여 고용량/고집적 아카이빙 스토리지 구성이 가능합니다. E484 모델과 스케일업 확장 시 최대 408개의 디스크 장착 및 8.16PB 물리 용량 구성이 가능합니다.
성능 모니터링
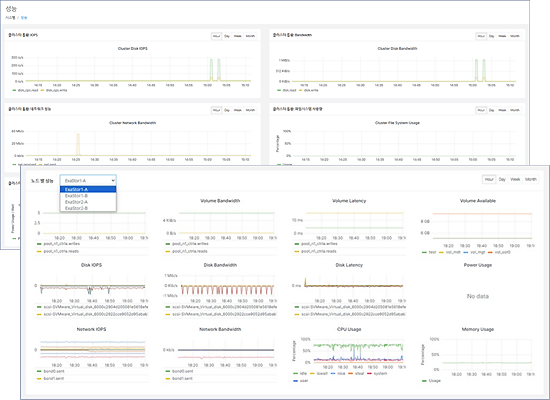
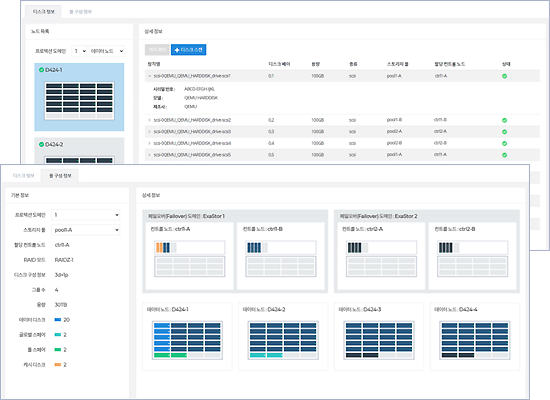
전용 관리 소프트웨어를 통해 클러스터와 각 로컬 볼륨의 IOPS 및 대역폭을 확인할 수 있습니다. 전체 노드 및 컨트롤러 별 네트워크 입출력 성능, 파일 시스템 사용량 및 전력 사용량, 컨트롤러 별 CPU/메모리 사용률 등을 실시간으로 모니터링합니다.
상태 모니터링
클러스터와 각 로컬 볼륨 별 사용량과 가용량, NFS/CIFS/Lustre 클라이언트 접속 현황 등을 모니터링합니다. 전용 관리 소프트웨어를 통해 시스템에 장착된 디스크의 상태를 실시간으로 확인하고 위치를 스캔하여 효율적으로 관리할 수 있습니다.
멀티 프로토콜 지원
NFS, SMB/CIFS, S3 및 POSIX 인터페이스를 지원해 다양한 사용자와 애플리케이션이 하나의 글로벌 네임스페이스에서 데이터를 공유할 수 있습니다. S3로 수집한 데이터도 별도의 이동이나 복사 없이 학습 클러스터에서 파일 형태로 바로 활용할 수 있습니다.
컨테이너 환경 연동
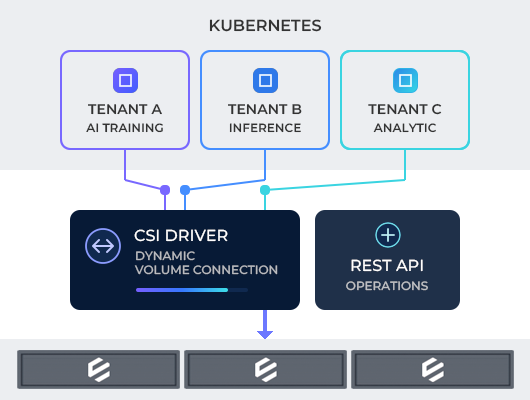
ExaStor는 CSI Driver를 통해 쿠버네티스 환경에 스토리지 볼륨을 유연하게 연결합니다. 멀티테넌시와 QoS로 워크로드별 자원을 효율적으로 관리하며, REST API를 통해 외부 운영 시스템과의 연동 및 관리 자동화를 지원합니다.
시스템 아키텍처
시스템 구성
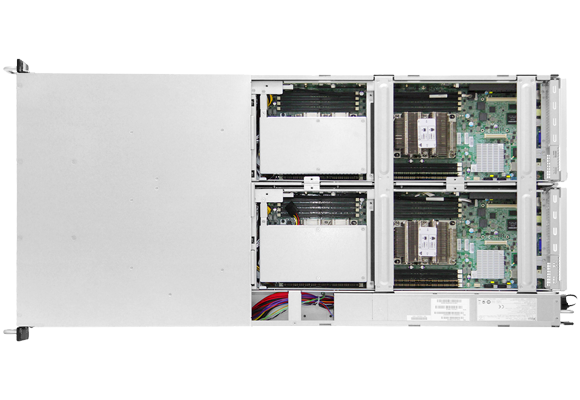
DC/SC 일체형
단일 Chassis 내에서 HA(Active-Active) 구성으로 고가용성 지원 (*DC에 한함)